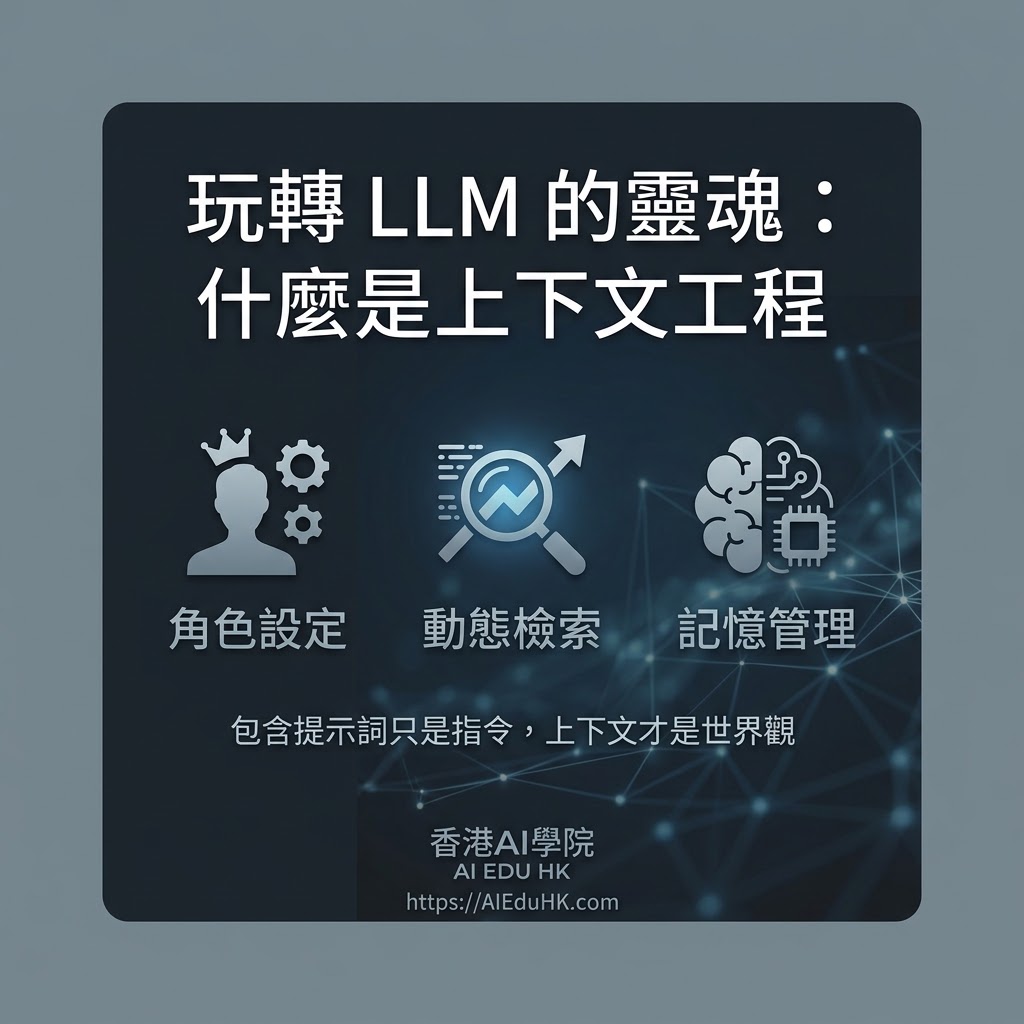
在生成式人工智能急速發展的今天,許多人都學會了編寫精準的提示詞(Prompt)。然而,當面對複雜的商業應用、長文本分析或自動化工作流程時,單純的提示詞往往力有未逮。真正決定大語言模型(LLM)表現上限的關鍵,其實是往往被忽略的「上下文工程」(Context Engineering)。
什麼是上下文工程?
上下文工程是指系統化地設計、管理、優化傳遞給大語言模型的背景資訊、對話歷史、參考文檔與結構化約束的技術。如果說提示詞是向 AI 發出的指令,那麼上下文就是 AI 理解這個指令的世界觀、記憶庫與工作環境。
在大模型的世界中,輸入的上下文決定了輸出的品質。一個精心設計的上下文能夠有效抑制幻覺、提升回答的準確度,並確保模型嚴格遵循特定規範。
上下文工程的三大核心要素
1. 系統指令與角色設定
明確定義模型的身份、專業領域、輸出格式及行為邊界。這為整個對話建立了穩固的框架,確保模型在處理後續輸入時保持一致的專業語調與邏輯。
2. 動態資訊注入與檢索增強
透過外部資料庫或即時搜尋,將最相關、最新的企業內部文檔或行業數據動態注入上下文之中,解決模型知識庫過期或缺乏特定領域數據的問題。
3. 記憶窗口與 Token 資源管理
在處理長文本或多輪對話時,合理分配上下文長度,過濾冗餘信息,保留核心關鍵歷史,避免模型因記憶過載而忽略重要指示。
如何在實務中應用上下文工程?
要有效建立高水準的上下文架構,可以遵循以下三個實踐步驟:
-
模組化設計:將背景資訊、規則限制與具體任務拆分為獨立區塊,便於維護與調整。
-
噪聲控制:嚴格篩選注入模型的參考資料,避免無關資訊干擾模型的注意力機制。
-
持續迭代測試:根據模型的輸出結果反覆優化上下文結構,建立標準化測試集。
提升您的 AI 實戰能力
想要系統性掌握大語言模型底層原理、提示詞設計與上下文工程的最佳實踐?誠摯推薦您查看及報讀香港AI學院的相關 「上下文工程 (Context Engineering) AI 課程」。透過專業導師的帶領,您將學會如何將先進 AI 技術深度融入實際業務場景,解鎖企業數位轉型的新動能。